2025年2月28日金曜日

うまくいったハイパーパラメータは何だったっけ?

 とんちんかんな記事です。

以前の記事(https://achromareport.blogspot.com/2021/11/blog-post.html)で順調に育つエージェントができた様子を紹介したが、再現しようとしても途中で設定変更するしよくまとまっていないので改めてハイパーパラメータをまとめることにする。

まずバッチサイズ。128から始まって可変で終わっている。最大値は1024だったと思うが、1024ステップを越えるエピソードは少ないので、実質一試合全部を読んでいることになる。本当に効率がいいのだろうか…。

LSTM レイヤーは3枚だったようだ。しかし、learn()の呼び出し方の変更後、昔あったようなパフォーマンスの低下はなくなったとも後の記事(https://achromareport.blogspot.com/2022/07/1.html)に書いてある…。

もしこれが本当なら、小さなバッチサイズでもいいことになる。しかしどちらにしても確認し直した方がいいような気もしなくもない。以下の設定で試してみることにしよう…。

Batch size: 4-128

LSTM Layers: 1

Learning rate: 1e-4

過学習になるかな…。

2025年1月23日木曜日

AIガオガエン再始動

 AI ガオガエンが止まってからかれこれ2年近く経ってしまった。取り巻く環境が変化し、また面白い事ができそうな気がしたので、活動を再開しようかと思う。

いったい何が変わったのか。列挙してみる。

  1. 大規模言語モデルにおいてトランスフォーマーが台頭し、他の分野でも有力なネットワーク構造だとわかった。
  2. 大規模言語モデル自体がコーディングの手助けができる程度に発達し、開発の労力が削減された。
  3. PytorchがMetalに対応し、GPUでのトレーニングが可能になった。
  4. CoreMLがpythonでも動き、ネットワークの実行にApple Neural Engine (ANE)が使用可能になった。
今までのAIガオガエンではデータ集めからトレーニングまで全て同じコンピュータで行い、しかもそのほとんどをCPUのみで行われていた。しかし、開発の途中でトレーニングのスレッドとデータ収集のスレッドは分離し、必ずしも同じコンピュータで行われる必要はなくなっていた。新しいセットアップでは計算機を二台用いてトレーニングとデータ収集を完全に分離し、かつGPUやANEに負荷を分散させることにより今までより大規模なインプットやネットワークを使えるようにすることを目指す。

また、アテンションを使うことで過去のどの動きを参照したらいいのかを把握し、今までより過去を気にした行動をとることが可能なように修正したい。かなり大規模な変更を加えることになり、作業量が心配ではあるが少しずつ解決していこうと思う。

とりあえずMetal Performance Shaderを使ったGPUでのトレーニングとANEを使ったネットワークの実行が可能なことは確認した。これらが望みのアーキテクチャで動くことを確認し、さらにアテンションを組込めるかどうかを検討していくことが次の課題になりそうだ。

2022年7月24日日曜日

もう1つ修正を施したらちゃんと育つようになった

 前回回帰ネットワークの実装ミスの話をしたが、もう1つだけミスしていたかもしれないところがあった。今までの実装では zero_grad() メソッドをエピソードの終了時にだけ呼び出していたのだが、learn() メソッドが呼び出される度に呼び出されるように変更した。

どちらが正解かははっきりしなかったのだが、裏で回していたKangarooで、これを毎回呼び出した方が安定して成長することがわかったのでこのような変更を加えた。これでバッチサイズが小さくなっても学習が途中で止まってしまうことがなくなった。

AIガオガエンの方でもそうなっているようで、Lv3を何度か攻略してみたところバッチサイズが小さくても過去に見られたようなパフォーマンスの低下が見られなくなった。やっと実装が完了した、ということになるだろうか。まだ問題が潜在している可能性はあるものの、今のところ不審な挙動は見られない。

今は学習率周辺のベンチマークをとっている。もしうまくいくようであれば過去に一度試したGRU、未来予測型、色の見えるエージェントなども順次試していきたい。それぞれ攻略するのに数日単位でかかるので気長な作業にはなりそうだが…。

2022年7月10日日曜日

回帰型ネットワークの実装ミス

うまく成長しない原因もわからないし、Switch本体のバッテリーも壊れてしまっていたこともあり、しばらく配信を停止していた。数日前にまた再開して再度以前の成長していた時の環境を取り戻そうとするもうまくいかず停滞していた。

何か間違いが見つからないかとまたコードを眺めたり、デバッガで値を確認したりしていたところ、一つ予期しない挙動をしている部分を見つけた。

以前回帰型のネットワークのバグ取り(トレーニング中に同じネットワークを2回使ってしまい、状態を変えてしまっていたバグ)をした時、もう1つ同じネットワークを用意することで解決したかのように見えた。ここに盲点があった。

トレーニングがうまくいくためにはこの2つのネットワークは全く同じアウトプットを、時間差をつけて出さなければならない。1つのエピソードを学習する際、2つ目のネットワークに最初のnステップの状態をあらかじめ入力して、nステップ分だけ進めておく。このようにセットアップして、以後1つ目のネットワークが変更される度に2つ目のネットワークにウェイトをコピーすれば、同じアウトプットを出し続けるだろうという算段だった。

何が問題だったかというと、この1つ目のネットワークと2つ目のネットワークが受ける入力はnステップ分だけずれているので、ネットワークの内部状態の変化が必ずしも同期しないということだった。すなわち、毎回ウェイトがコピーされるとは言え、2つ目のネットワークはずれているnステップ分の状態をウェイトが更新される前のネットワークで処理することになるため1つ目のネットワークと全く同じことをするわけではない、ということになる。これによって内部状態にわずかなずれが生まれ、そのずれは蓄積されてエピソードの後半に向けて増えていく。

このバグの存在とバッチサイズを大きくすると挙動がよくなるという現象は無矛盾である。

解決方法は明快で、ウェイトをコピーするタイミングで内部状態も同時にコピーすることで対応できる。(内部状態を更新せずにネットワークを使用する、という解決方法もあり、こちらの方がリソースの節約にもなるが、コードの更新箇所が多くなるので見送った。) これが最後の実装ミスだといいのだが…。

今後は、まず今まで走らせていたLv5クリア前のモデルがパフォーマンスを改善するか確認し、それが確認されたらバッチサイズを小さな値に戻してまたLv3スタートで最初から学習をさせることにする。大幅な学習期間の短縮が見られる可能性もあるが、あまり期待しないようにする。

2022年4月27日水曜日

OSアップグレードの不具合で成長しなくなった話と別のOSアップデートで直った話

自分にコントロールできないものに大きく左右されることもある。

1月21日、AI用のMacをMonterey(12.1)にアップグレードした。ガオガエンでマルスを相手にしていたところ待ち合いが長くなって成長が鈍化したため、相手をウルフに変えた後およそ2週間後のことだった。

この時はウルフはやや停滞気味だったのだが、このアップデートの直後に少しパフォーマンスを落とした記憶はある。どういう理由でパフォーマンスが落ちたのか不思議には思ったものの、トレーニングを継続させたところ再びパフォーマンスがゆるやかに上昇していったので深刻な問題とはとらえずにそのまま放っておいた。

そのウルフはガオガエンを倒せるようになることはなかった。

ここで疑問に思い、もしかしたら今のネットワークの設定に限界があるのではないかと思い、今考え得る手法でベンチマークをとってどの設定がいいか確認しようと思って、ウルフチャレンジなる企画を始めたのだが、どんな設定にしてもうまくいかない状況が3ヶ月程続いた。

この間、ネットワーク構成はおろか、ステージ、ファイターに至るまで様々な要素を変更して試したがどれもうまくいかず、結局元の設定に戻ってきてもやはりうまくいかない始末。これは何かあると思って他の原因を探ろうとしたときに、以前視聴者の方から「動画が音ずれしている」と報告をいただいたのを思いだした。

音声の方が先に来るタイプの音ずれだったのだが、音に対して映像が遅れてPCに届いているということはAIが現状をリアルタイムで捉えられていないということである。今思えば音ずれの報告があった時点で気がつくべきだったのだが、すっかり失念していた。数秒の遅延でもゲームをする上では致命的である。ましてAIでやろうとするとそこから成長できなくなるのは当然なようにも思える。

音ずれは始めてから数日で現れるようだった。実際に映像の取得が遅れることを確認するため、音ずれの訪れを待った。……。

4月22日、映像取得の遅延を確認する前だったが、配信が中断されたのを機会にOSを 12.3.1 にアップデートした。不思議なことにここから再び音ずれの症状がなくなり、AIも成長を止めなくなった。同日開始した配信で 4月26日現在まだ成長を続けている。いつものAIガオガエン対Lv3マルスだが、あと2日程度でクリアしそうな勢いだ。

いくつか気になる点もまだある。

音ずれの症状が起こる前はOBSによる配信が一定期間(およそ1週間程度)で中断されることが多かった。多くの場合CPUパニックによるものでコンピュータ自体が再起動してしまっていた。macOS 12.1になってからはその不具合はほぼ解消され、ほぼ一ヶ月程度不具合なしで連続配信できたこともあった。それがまた 12.3.1 になってから以前と同様に不安定になった可能性がある。まだデータがたくさんとれているわけではないが、22日から今までの間に既に一度CPUパニックで再起動している。全ての不具合が同時になくなることはないのだろうか。

少なくともまた何らかの実験ができる環境が手に入ったのはいいことだ。今までうまくいかなかったベンチマークの作業をまた継続したい。またルキナに戻してみるのもいいかもしれない。

2022年2月7日月曜日

ウルフチャレンジシリーズ【深層強化学習】

順調に育つエージェントができたのかと思いきや、セルフプレイの段階でやはり成長が止まってしまっているように感じたので、また一段階戻って手法のベンチマークをしてみることにする。

環境を少し変えて行う。理由は以下の通りである。
・CPUにはウルフを使う。基本的には近距離が強いファイターだが、飛び道具による待ち合い回避や牽制ができるので。
・1Pファイターにはルキナを使う。ゲームをややこしくしたり、記憶を要求するギミック等がなく、撃墜方法が豊富で多くの面で高性能なので。

最初に試すのは今までに使ってきた手法である。すなわち、
・畳み込み層の後にLSTM3枚
・並列で未来予測層LSTM2枚
・Batch size は 4から2048の間でランダムに決まる


今回試したいことがらは、
・結局LSTMは何枚必要なのか
・batch size はここまで大きくないといけないのか
・未来予測層は有用なのか
という点である。

調べるのにかなり時間はかかると思われるが、知見を貯めていきたいところである。

2022年1月17日月曜日

これからホムヒカを始めようと思っている方へ

 2021年末からほぼ毎日ホムヒカを触っていたのですが、今日魔境街道に到達したので、ここまでで理解したことを書いておきます。

この記事の対象は既にスマブラを他のファイターでやっているけれど、ホムヒカを新たに始めたいなと思っている人になります。

ひょっとすると全キャラVIPを目指す一環でホムヒカを使いたい人やホムヒカ対策をしたい人にも役に立つかもしれません。

ある程度用語の理解が必要になるのでご了承ください。


既に使い手の方にはほぼ当たり前の内容になると思います。


コンボについて

できるに越したことはないですが、簡単なものから始めてもいいかと思います。

最初のうちは、下強、上強、上Bあたりをいつでも頭に置いておいて損はないと思います。

上Bで〆めますが、展開継続にならないし後隙もあるので通らない場合は無理してしない方がいいです。

上Bの着地隙はパニッシュメントレイが15F、レインボーダストが20Fなので、一段目を外した場合はパニッシュメントレイにした方が若干コンパクトになります。

もちろん崖を掴める場合は着地隙は関係ありません。

コンボについては調べれば色々出てくると思うのでここでは割愛します。


立ち回り


差し込みに有用な技

めくり空N、とりわけダッシュで近づいて小ジャンプ登り空Nをめくって出すのが比較的安全で展開も良いです。

当たったら浮いた方向を見て着地を狩りに行きましょう。

着地の位置を近くにしないとめくり空Nからコンボはありませんが、より安全になります。

クラウド、クッパ、ゲッチ等の速いガーキャンを持っている相手にはめくり空Nは控えましょう。


ジャンプで近づいてくる相手に二段ジャンプを合わせて空Nをかすめて当てるのも比較的安全でリターンが高い方法になります。


ヒカリのDAは使い易いですが、横強、下強より後隙が長いので、滑り横強(ダッシュ中に左スティック反転、右スティックを進行方向に)か滑り下強(ダッシュ中に左スティック反転、右スティックを下に。タイミングがずれると反転してしまうので要練習)をおすすめします。それぞれコンボ始動の技になります。

ステップ中は滑り強攻撃はできない(ですよね…?)のでDAでステップの範囲内の相手にはDAで妥協します。

DAはなるべく先端か密着(めくり)で当てます。半端にくっついて当てると痛い反撃をもらいます。


一度展開を取ったら相手の受け身や着地に合わせてひたすら技を合わせます。当たらなかったりガードされても次々と技を繰り出して展開を維持しましょう。連打に使う技は下強、弱あたりがおすすめです。

相手の着地はDAではなく滑り上強で取るとよりコンパクトになりますし、その後のコンボも繋がります。台上にも当たります。ダッシュの状態から台上に直接上強できるようになっておくと(ダッシュ中に左スティックを反転して右スティックを上)いいでしょう。


ホムラの立ち回りは難しいですが、リーチを押し付けたい時と、ブレイズエンドが刺さる時は使います。

先端当てを徹底して被弾を抑えるようにしましょう。

空下はリターンが高いですが、ガードされると反確が多いので、基本的に差し込みで使う技ではないと思います。使うとしても引き慣性か先端で。

みんな空下を本気でガードしてくるので、すかし掴みは通ることが多いです。例外は差し込みに上Bを安全に入れ込めるタイプのキャラ(ゲッチなど)になります。


ブレイズエンドはジャンプが低い相手(スティーブ、格ゲーキャラなど)と飛び道具キャラによく刺さります。

ほぼ全ての飛び道具を打ち消しながら飛んでいくので飛び道具相手にヒカリでも立ち回りが難しいと思ったらブレイズエンドを投げるのもありだと思います。

反射持ちの相手にはかなり反射を狙われるので注意しましょう。大ダメージを受けます。剣が横回転の時は反射されますが、縦回転になると反射できなくなるので、反射を狙っている相手には届くぎりぎりの距離で打つと反射されずに当てることができます。横Bスマッシュ入力で飛距離も変わりますので、うまく当てましょう。


いつチェンジするべきか

基本的にはヒカリで立ち回り、有利展開(崖、着地狩り)でホムラにチェンジがいいと思います。

撃墜できない%の場合はヒカリで崖狩りするのは大いにありです。


掴んだらどうするべきか

0%の時は下投げ、空後、空後、上Bのコンボを狙います。

1F暴れや回避があるファイターは抜けられることも多いと思いますので、無理せずにただ上Bでもいいかもしれません。

空前や空上で展開を取るのもありかと思います。


中%の時は下投げ後、基本的には二段ジャンプ空前を狙いながらベク変を確認して内側ならジャンプの二段目を合わせて空上をしています。

確認が速い人にはもっといい方法があるかもしれません。


70%前後で相手のラインに余裕がある場合は前投げからダウン展開が狙えます。弱で止めて横スマでも下スマでも好きな方をどうぞ。残念ながらベク変ミスでもないと撃墜はできません。相手がうまくなってくると受け身を取られるかジャンプで逃げられますので、読み合いをする形になります。


高%ではOP回復の掴み打撃継続か前投げが基本になります。横移動が乏しく着地の弱い相手なら上投げもありかもしれません。


ホムラは低%で下投げから空前 or 空上のコンボがあります。空前の方が若干威力が高いですが、台がある場合は空上が2回当たるのでそちらを優先します。


撃墜手段の変化

だいたい中くらいの重さのファイターを基準に書きますので相手によって適当に加減してください。


ホムラの空下絡みだけでかなりの数の撃墜方法があり、状況に応じて適切な選択肢をとらないといけないので実は結構厄介です。

ホムラの空下は持続4Fで、1F目が弱メテオ、2F目が強メテオ(剣はほぼ真下)、3,4F目は斜め上に飛ばします。

メテオからのコンボで広い%帯での撃墜が可能です。


約45%

ホムラ空下最低空→横スマ

空下が先端で当たった場合か、ホムラに相手から離れる慣性が付いている場合は横スマが確定します。

確定の条件が厳しい上、崖から離れていると撃墜しないのであまり狙いませんが、どうしても早期撃墜したい場合に使う可能性があります。


約65%

ホムラ空下最低空→微ホールド上スマ

早期撃墜のメインの択になります。

どのくらいホールドできるのかはトレモで確認して感覚を身につけておくといいと思います。

若干%が上がると微ホールドなしで撃墜できる帯域がありますので、その帯域では振り向きや、位置調整も可能になります。


約85%

ホムラ空下→プロミネンスリボルト

このあたりから上スマが確定しなくなってきますのでプロミネンスリボルトに繋げます。

台がある場合は台上でプロミネンスリボルトが当たるので撃墜力が上がります。

相手がちゃんと外ベク変した場合は撃墜しません。


約100%

ホムラ空下→大ジャンプ空後

位置調整が必要になります。振り向いて空後しても、前に慣性をつけて飛んで空後しても当てることができます。

空前でも撃墜可能な位置なら空前でもOKです。


そろそろホムラの着地狩りDAで撃墜が可能になるあたりです。DAでの撃墜は意外と使えますが、先端を当てないと飛ばないし反撃も多いので先端を当てられる距離感を掴んでおきましょう。

このあたりからヒカリの横スマが崖端で撃墜可能になります。崖つかまりっぱなしに対して下強横スマが確定したりします。


約120%

ホムラ空下→二段ジャンプ空上

ここまで来るとかなり当てにくくなってきますが、最低空でメテオすればまだ確定する攻撃があるはずです。

このあたりから空中で空後を当てると撃墜になります。


約140%あたりから

空下をメテオで当てても何も繋がらなくなります。空下より空後を振りましょう。空下、空後は小ジャンプ登りで出した場合急降下しなければ着地隙が発生しない(オートキャンセル)ので、着地隙の消せる撃ち方をあらかじめトレモで確認して練習しておくといいと思います。

ヒカリの上スマ(発生9Fのガーキャン可能な撃墜方法)がこのあたりから撃墜できるのでチェンジも考えます。

崖外に出した場合はホムラの弱でも撃墜が可能です(後述)。

各種空中攻撃、とりわけ空中で空Nを当てても撃墜できます。

ホムラ上強での撃墜も可能になりますので、空上などでの着地狩りを匂わせて回避を誘い、上強で撃墜するという流れも可能です。上強はよく飛びますが、ガードされると反確が多いので注意しましょう。横強はなぜかガード硬直が長いので先端なら反撃はあまりありません。


約160%あたりから

ブレイズエンドでの撃墜が可能になります。数ある撃墜方法の中でもかなり安全な方なのでここまで来てしまった場合は被弾しないように立ち回りながらブレイズエンドを当てられる隙を伺いましょう。


約200%あたりから

最も速い投げバとしてホムラの下投げで撃墜可能という噂です。


ホムラの空下2F目(強メテオ)を台の下の相手に当てる場合

かなり広い範囲(60%〜110%くらい?)で上スマが確定し、位置も高いのでほぼ撃墜になります。

積極的に狙ってもいいですが、台下の相手に隙を晒すことになるので上スマなどで撃墜されないように注意しましょう。


70%くらい?で後ろ投げが台上ダウン展開になったりします。

ホムラの上スマで全狩りできるようなので狙ってみてもいいかもしれません。(あまり使ったことはありません)


ホムラの空下による低%での撃墜が有名なファイターなので狙いたくなりますが、有名すぎて空下を厳重に警戒されるためそうそう当たりません。狙いすぎて被弾するよりはさらにヒカリで地道に%を稼いで他の方法で撃墜した方が被ダメが安く済むことも多いので、相手の動きを良く見て判断しましょう。


復帰阻止について

基本はホムラの空前

相手が高い位置にいる時に復帰阻止に行くと、失敗しても展開が悪くなりません(そのまま崖展開に移行)

深く行く場合はホムラでしっかり高度を合わせてついていって当てます。

ホムラの空中機動は悪くないですが、技を振ってから行動できるまでにかなり時間がかかるので、どこまで行けるのかを事前に確認しておきましょう。特に空下は当たると強いですがジャンプせずに崖を降りて撃つ場合、ほぼ最速にして一切急降下しないようにしないと戻れなくなります。


崖の真下に対してフレイムノヴァをする手もあります。


ヒカリでする場合は空前、ライトニングバスター、上Bなどでも復帰阻止できますが、ジャンプを潰せるかよほど高%でもない限り撃墜につながることは少ないです。


崖下の内側にいる相手にヒカリで上Bすることで崖メテオを狙うこともできます。剣が当たった場合は回避暴発も狙えるレインボーダストの方が倒せる可能性が高そうです。


崖狩りについて

ヒカリの方が狩れる確率は高いですが、リターンはホムラの方が高いです。

ヒカリでやる場合は、崖端への空N置きでジャンプ上がりをケアしながら相手の行動を見ます。

回避上がりにも空Nのランディングフォースが当たることがあるので、位置どりは適当にばらすといいと思います。

空Nが当たったらあわよくばもう一発何か当ててもう一度崖外に出します。

単調にならないように、空N連打だけでなくその場上がりを掴める位置でガードしたりしてもいいかもしれません。

相手の崖上がりの択に合わせて行動を変えましょう。


ホムラの場合は120%くらいから横強での撃墜が狙えるので、横強先端が当たる位置で待機してその場上がりに合わせるというのが1つ。しかし横強先端で当てようとすると攻撃フレームの最後を当てないといけないので、その場上がりに対しては無敵が切れる1Fにぴったり合わせる必要があり、難易度は高いです。

より丸い択はガードしながら掴める位置で待って、上がるのを見て掴む。です。こうやって135%くらまで溜めると次の崖で弱での撃墜が可能になります。


135%くらいのホムラでの弱撃墜は、ジャンプ上がりとその場上がり(あと状況によっては崖離しジャンプも)をケアする択になります。比較的安全で本命択であるこの2つを同時にケアできるのは強いですが、もちろん読まれると回避上がりされてラインも失うので注意しましょう。

位置は掴みが届くギリギリよりも少し前で、相手が上がってきそうだなと思ったらAを押しっぱなしにするだけです。

ホムラの弱1段目は10Fでループし、持続が3Fあるのでその場上がりでガードを入力されても30%の確率で当たります。ガードをされたらこちらにも弱を1段か2段でやめる選択肢があるので、最悪読み合いです。ジャンプ上がりはほぼ狩れると思っていいと思います(当たる位置によってすっぽ抜けることはあります)。


撃墜に貪欲になりたい場合は60-80%あたりからホムラで崖狩りをして、一点読みの空下を当てるのも手です。わざと近づいて回避上がりや攻撃上がりを誘ったりすると成功率が上がります。


復帰について

ホムヒカの一番の弱点になります。特に今まで復帰力のあるファイターを使っていた人は要注意です。

崖外で二段ジャンプを使った場合、ちょっと小突かれると撃墜されます。

上から帰ろうとしてすぐにジャンプを切るのは基本悪手になります。代わりに移動回避で崖を掴んだり早めの上Bで掴んだりしましょう。

ヒカリは上Bの光弾が出てしまうとほぼ頭が崖上に丸出しになってしまうので、高さを調整して光弾が出る前に掴むか、高さが足りない場合は逆に低めにしてなるべく頭が出ないようにします。

崖に近い高さで上Bを出すと振り上げの判定が崖上に出るので相手を追い払いたい時に便利です。ただし、カウンター持ちには注意しましょう(特にソラ、ジョーカー、ガオガエン)。

それでも2Fを狩られることはあるので、可能ならジャンプを温存してダイレクトに上Bすることをおすすめします。ジャンプさえあれば帰れます。


ホムラの上Bは攻撃判定が崖上に出ないかわりに、ヒカリより頭が出にくいので崖に掴まりやすいです。崖上で狙われている場合はホムラで帰るのが若干安全かもしれません。


チェンジは何度でも使えますので、2回目以降の回避として使います。ホムヒカにはあらゆる復帰阻止がバンバン飛んでくるので、どのタイミングで無敵が発生するのか確認しておいて合わせられるようにします(下Bの後、6-18Fが無敵なのですがこれを合わせられるように感覚で覚えます)。


低く飛ばされた時は内側斜め上回避してジャンプを残し、二段ジャンプと一緒に一回チェンジして上Bをするのが最も距離が稼げると思っています。

大きく飛ばされた時はジャンプを残した方がいいのか回避を残した方がいいのか相手に応じて考えて決めます。


ホムラの上Bは横入力をすると少し動けます。高度ちゃんと合わせると意外と遠くで撃ってもふわっと掴めたりするので、これもどのくらいの距離で掴めるのか確認しておきましょう。


ブレイズエンドを崖端に投げてジャンプと回避で崖を掴むのも比較的安全な帰り方の1つです。


崖上がりの択について

崖離しジャンプはハイリスクだということは常に頭に置いておきましょう。

ヒカリはジャンプ上がりとその場上がりの読み合いをするのが一番安全かと思われます。

相手が掴みを狙っている場合はジャンプが本命になります。ジャンプができてしまえば機動力で逃げられる事が多いです。


ホムラの崖上がりは若干大変ですが、崖から少し離れている相手には崖離しジャンプからブレイズエンドを投げながら上がる択も使えます。(ただし飛び道具には注意!)


攻撃上がりのリーチはかなり長いので結構使える時もあります。


因果律予測について

各回避行動の2Fあたりから3-4Fの間(回避の種類によります)に攻撃判定を受けると相手がスローモーションになります。スマッシュなどが確定します。相手の飛び道具にも使え、その場合は相手本体もちゃんとスローになります。飛び道具に前回避を合わせて相手に近づいてスマッシュすることもできますので、対飛び道具の1つになります。

因果律予測の受付時間中は、掴みを回避することができませんので、ヒカリは他のキャラより殴りの回避は速く、掴みの回避が遅いということになります。強い掴みを持っている相手(クッパ、ガオガエン等)には要注意です。掴みを狙われている時はその場回避(7F)より弱暴れ(2F)の方がいいでしょう。

因果律予測中は崖を掴みません。崖に掴まろうとして回避した時に殴られて因果律が発動しそのまま落ちることもあります。

因果律予測は強いですがヒカリの回避の後隙は他のファイターより長いので、相手に隙を晒す形での回避はかなり危険だということも覚えておきましょう。

2021年11月13日土曜日

順調に育つエージェントができた

とりえあずのお祝いを。

前回の記事の終わりで、さもパフォーマンスが落ちる原因がわかったかのような口を聞いたが、仮説検証のために色々と実装をしたものの結局のところパフォーマンスが落ちる原因はわからなかった。しかもコードの重要な部分にバグがあるのも見つかり、しっちゃかめっちゃかになった。バグの修正後に比較的安全なパラメータ調整をして臨んだところ安定して成長するようになったのである。今回の記事はそのあたり(10月上旬あたりから約1ヶ月程度)のまとめになる。長くなることを最初にお伝えしておく。

過学習と正則化

前回の最後に立てた仮説は「過学習によってそれまでと少しでも違う動きをする相手に対応できなくなっている」というものであった。過学習とはデータの中の一般化できない部分にまで適応してしまう現象のことである。深層学習では過学習をどのようにして避けるかが一つの大きなテーマにもなっており、様々な手法が開発されている。データの数が少なければ少ないほど過学習のリスクも高まる。こちらの記事に詳しく解説されている。

深層強化学習の場合はデータを常に作り続けるために他の深層学習の分野と比較して過学習に対する対応が薄い。このプロジェクトで使っているRainbowというモデルでも明示的に過学習を防ぐ方法は取られていない。Rainbowの論文ではAtariのゲームのシミュレータを用いているので、データ取得と学習のステップをどの程度の比にするかを選べるようになっている。ここでデータ取得の頻度を比較的大きくしておけば過学習を防ぐことができる仕組みになっている。

AIガオガエンの場合は実機を用いるためデータ取得の頻度が実時間で決めらている。一方学習は別スレッドで動いているためステップ数はCPUに可能な最大値となっている。LSTM2枚程度のモデルではだいたいRainbow論文と同程度、つまり4ステップごとに1回程度のペースで学習をする。一回の学習で32ステップを読み込むため、実時間に対して8倍程度の速度で学習をすることになる。これもRainbow論文と同程度である。

これだけ聞くと過学習の心配はなさそうに感じるがもちろん環境が違うためちゃんと成長するために必要なデータの分量も変わってくる。LSTM1枚のモデルが2枚のものより早くパフォーマンスが落ちるのを観測したとき、過学習の可能性を疑ったのである。

過学習が起こったらどうすればいいのか。先述の記事にもあるように、「正則化」を行うのが順当な手法である。このプロジェクトでは最適化の手法であるAdamにWeight Decayを加えたAdamWというものを使った。

もうお分かりかと思うが、これで問題は解決しなかった。詳細は割愛するが、Weight Decayを導入してもパフォーマンスの低下は防げず、逆にWeight Decayを弱めたところから成長を始めるエージェントなどもいて、かえって邪魔になっている印象であった。

色

次に試されたのが色が見えるエージェントである。Rainbow論文にならってAIガオガエンは白黒の映像を与えられていたが、ステージが緑色、ガオガエンが赤、マルスが青で、それぞれのカラーチャンネルにうまく対応していたため色が見えるエージェントは物の識別が用意になるのではないか、という仮説があったからである。色を導入するとデータ量が増えるため、今までよりも少ない数のリプレイメモリしか保存できなくなるのがトレードオフである。

これも試されたものの、白黒のエージェントに勝ることはなく、短期間で実験を終えることになった。

ハイパーパラメータチューニング

試せる案が減ってきたので、ノイズを増やす、マルチステップの数を変える、などの妙な変更を始めた。ここで試したかったことは、「パフォーマンスの低下は過学習の結果ではなく、ガオガエンが成長する上で必要なステップで、それを越えた先に成長がある」という仮説の検証であった。このエージェントでは成長速度を上げるため、裏でやっていたAtariのパラメータを一部ひっぱってきてやっていた。つまり、バッチサイズを大きく(32→128)し、学習率を上げる(1e-5→1e-4)という方法だったのだが、どういうきまぐれからかLSTMレイヤーの数は3枚にしてみた。

蓋を開けてみると、このエージェントの成長はとても遅かった。バッチサイズを大きくし、ネットワークを重くした結果、データ取得に対する学習ステップが100ステップに1,2回程度まで下がってしまい、結果Lossの現象は今までのLSTMモデルより随分ゆっくりになった。次のグラフはLSTM1枚のモデルと今回のモデルの比較である。両方Lv3スタートである。


Lossが2.0程度に戻ってくるまでに先のモデルは500エピソード程度だったが、今回のモデルは3000エピソード近くかかっている。そしてこのエージェントはその後もゆっくりと成長を続け、Lv3をクリアする直前まで来た。ここまでにおよそ5日程度かかっている。

ここで一度クラッシュしたのと、メモリ構造を書き換えるために止めたため、クリア前ではあるがLv4に移行することにした。以下がLv4の経過である。
しばらく走らせたものの、クリア目標である70%に到達するのは遠いように見えたので、クリア条件を60%に改めてクリアしたことにした。次がLv5の経過である。

ここに来て減速を始めたのである。結局駄目だったかと落胆したものである。パフォーマンスが下がるにつれてガードが増え、クラッシュするまで守るようになったのが印象的であった。パフォーマンスが落ちつつも試合時間が長くなっているあたりにその様子が間接的に伺える。

未来予測型

その次に試されたのが未来予測型のネットワークである。情報を処理するLSTMの前に未来を予測する部分を並列で作り現在の情報と予測された未来の情報の両方を使って最適な行動を選べる(はずの)エージェントである。次の図の左側の水色の線の部分が未来予測の部分である。

着想はSSBMの深層強化学習を行ったFiroiu氏のこの論文からである。AIガオガエンの約300msの入力遅延を未来予測でごまかせないかという話である。

結果から言うと、未来予測型がしっかり完成する前に、回帰ネットワークまわりのバグが見つかったので保留になった。なのでこの部分は未完成である(一応完成はしているが未検証、といったところか)。

回帰ネットワークのバグ

問題は「トレーニングの最中に同じネットワークを2回使ってしまっていた」というものであった。回帰ネットワークでなければ何度使おうが同じ入力には同じ結果を返すので問題ないのだが、回帰ネットワークは内部状態を持つため2回使うと違う結果が出るし、その次のステップ移行にも影響してくる。トレーニングにおいても同じネットワークは一度しか使ってはいけないのだ(内部状態を元に戻すという処理も可)。今回は2回使わなければいけない場面でネットワークを2つ用意するという対応をとった。

このバグに間してはバッチサイズを大きくすることによってもある程度対策が可能なため、バッチサイズの大きくした時にパフォーマンスが低下しにくくなる1つの理由となり得た。

GRU vs LSTM

回帰ネットワークのバグを修正するついでに計算を軽くしたい欲求も出てきた。もし今まで成長していなかったのが回帰ネットワークのバグのせいならばLSTM1枚でもちゃんと成長する可能性がまだ残っている。

それと同時に、今までのLSTMの知見が眉唾ものになったために、少し他の事を試すいい機会になった。GRUというLSTMと同等の性能でパラメータが少なく計算と学習が少し早い回帰層があり、これとLSTMのどちらを使うか迷った結果今まではLSTMを使っていたのだが、ろえを機会にGRUを試してみることにした。以下がGRUでLv3から学習を始めたときの結果である。

最初大きなバッチサイズ(4096だったか)で始めて、2200epあたりで成長の遅さにしびれを切らしてバッチサイズを小さく(128)した。そこからしばらく走らせたものの、パフォーマンスの低下が見られたので仕方なく打ち切った。LSTM3枚のモデルがうまくいっていたため、このままここで時間を使うのは勿体ないかと思い、これも一旦保留にしてLSTM3枚のモデルに戻ることにした。

最後の変更:バッチサイズをランダムに

結局まともに動いているならいいかということでLSTM3枚でLv5で調子がよかったあたりから再開した。次のグラフの14000epあたりから修正されたLSTM(バッチサイズ大)が始まる。
バッチサイズの変更の伴って報酬は急上昇し(QもLossも)あっさりとLv5をクリアした。Lv6も同様でさほど苦労せずに攻略した。Lossはバッチサイズを大きくして以来増え続けている。
Lv7の途中で少し成長に鈍化が見られた。
上昇を続けていたLossもここで現象に転じ、過学習の様相を見せ始めた。ここで、新たな正則化の手法を導入した。バッチサイズを固定された数からランダムに変更したのである。

学習に用いるデータは1試合ずつ取り出して使われるのだが、バッチサイズを固定しておくと、同じ試合を取り出した時に切り分け方がいつも同じになる。これをランダムにすることで、同じ試合でも別の切り方になり、ネットワークにとって少しずつ違うデータに見えて、正則化が働くのではないかという算段である。

そのランダム化を3700epあたりで導入した結果、以下の図のようにパフォーマンスがまた回復してLv7をクリアすることができた。最後急激に報酬が落ちたが、あまり気にしないことにした。その後もこのエージェントは順調に成長し、ついに当初の目標であるLv8のCPUマルスを攻略した。

これで少なくとも安定して成長するエージェントができたことになり、いよいよAI同士によるセルフプレイの準備を始められる段階に入った。

確認事項1: クイックモードをやめたらどうなるのか

今までのトレーニングの大部分はデータが速くとれるクイックモードでやっていたが、通常モードと比べると入力遅延がやや大きい、フレームスキップがより頻繁に起こる、FPSが微妙に違うなどの問題があって通常モードに戻したときにどうなるかという検証が行われていなかった。人間は通常の時間でプレイしているため、通常モードで動かせないのは致命的になる。セルフプレイを本格的に始める前に通常モードに移行できるかを確かめることにした。

クイックモードでLv8マルス攻略まで鍛えたガオガエンを通常モードで戦わせた結果がこちらである。

ご覧の通り、最初こそ少しパフォーマンスを落とすものの、比較的簡単に順応することがわかる。

確認事項2: 終点から戦場にするとどうなるか

もう1つ確認しておきたかったのが台の有無にどう対応していくかである。スマブラは縦にも横にもキャラが動くゲームで、ステージ上の浮遊する台の存在によって戦術の幅が大きく広がる。もし実戦を意識するのなら、台有りでの戦いは避けられない。セルフプレイを始めるにあたって、台なしの環境で育ててしまった場合、台ありにシフトしたかったら両方のエージェントを同時に鍛えなおす必要がある。ゲーム内CPUが使えるうちに台の有無に適応できるかの確認をしておきたい。

次の図は、Lv8CPUマルスを終点で倒したガオガエンが戦場(両方エレクトロプランクトンではあるが…)を使った時の結果である。

クイックから実時間に変更した時と比べて最初のパフォーマンスの落ち込みは大きかった。ほぼ全然勝てない状態に戻ったものの、そこそこの時間で勝率を5割程度まで戻すことができた。

この挑戦中にセルフプレイ用の機材が届いたので、このエージェントを叩き台としてセルフプレイを開始することにした。

続きは次の記事で…。


2021年9月23日木曜日

回帰型ネットワーク(LSTM1枚からまた2枚へ。あれ?)


 2枚のとは違うのか?

大した違いはないんじゃないだろうか。結局のところ回帰レイヤーは自分の出力が自分に返ってくるのでNユニットの2枚のLSTMでできることは2Nユニットの1枚のLSTMでだいたい可能である。(返ってくるまでに1ステップの時間がかかるので全く同じというわけではないが。)

同じユニット数だともちろん2枚の方が色々なキャパシティが上がるとは思うが、同時に回帰レイヤーのトレーニングは時間ステップを遡りながら行うので重くなりがちである。実際に1枚のものと2枚のものではだいたい3割程度、1ステップの学習速度に違いが出る。

一方シンプルな系(Atariのゲーム)で学習成果を試したところ、1枚のものも2枚のものもだいたい同じステップ数だと同程度のパフォーマンスになる。だとすると1ステップあたりの学習が早い1枚のものの方が有利だということだ。もちろん複雑な系の場合はどうなるか不明である。

最初2枚のものから始めたのは、PyTorchのデフォルトの値が2枚だったからで、特に深い理由はなかった。その後、OpenAIのDota2のAIがLSTM1枚で行われていることなどを知って、1枚の方がよいのではないかと思うようになった。

で、1枚のものと2枚のもの、試したところ実際どちらがよかったのかという話だが、残念ながら結論が出なかった。次の2枚の図を見ていただきたい。


上が1枚のもので、下が2枚のものである。枚数以外はほぼ同じ条件である。2枚のものはゴールラインの0.5を越えたので止めたが、1枚のものは越えなかった。Rewardだけ見ると勿論2枚の方が成績がよいのだが、このあたりの数値はノイズが大きくもある。Lossの値を見ると確かに1枚のものの方が早く収束しているし、値も低く保たれている。Qの最終値も大きいし、何なら先に0に到達したのは1枚のものの方だ。どちらが先に0.5に到達したかというのは、偶然性の寄与するところが大きいように思われる。

問題はこの後だった。2枚にしようかな、と思ってその先に進んだ結果、途中で成長が止まってしまったのだ。次の図はLv2をクリアした2枚のモデルでLv3に進んだ結果である。

まだ順調に進んでいる。Qの値がふらついているのも相手の変化に合わせて再調整したためと読みとれる。そして、Lv4である。
突然勝率を下げ始めたのである。行動にもおかしな様子が顕著に現れていた。自滅の数が極端に多くなったのである。Qも下がりっぱなしで元に戻る気配もない。このあと2枚のモデルでLv3の最後から始めたり、3ストックにしたりLv2まで戻したり、1枚のモデルでやったり学習率を上げたりしたが、結局どのモデルもある段階まで学習すると、そこからパフォーマンスを下げて戻らなくなることのが観測された。回帰ネットワークを導入する前は確かそのようなことはなかったと思うのだが、これはいったいどういうことなのだろうか…。
次の記事では、なぜそうなったかの仮説と、解決策についての議論をする。


2021年9月20日月曜日

回帰型(再帰型)ネットワーク(LSTM2枚)

 強い。

時系列予測などによく用いられる回帰型ネットワークを実装した。英語では Recurrent Neural Network (RNN) と呼ばれ、再帰型ネットワークとも訳される。出力を次のステップの自分の入力に入れることでループを形成し、原理的には無限ステップ離れた過去の情報にもアクセス可能になる。詳しい説明はこちらの記事などを参考にされたい。(英語が読める場合はこっちのブログ記事の方がいいかも。) 今回の実装ではLSTM(Long-Short Term Memory; 長-短期記憶)という型のRNNを用いる。

時系列を認識するタイプのネットワークなので、時間の流れを適切な順序で入れてやる必要がある。今までの学習方法ではランダムな時間を取り出してきてトレーニングしていたので、変更する必要があった。新しい方法では1試合のデータを丸ごと取り出してきて、それを1から試合終了まで順番に入れることになった。バッチサイズは今まで通り32でも大丈夫なようだった。これに伴ってメモリ構造を一から書き直す必要があり、更に Prioritized Memory が(実装が面倒だという理由で)失われた。一応こちらの論文を参考にして、完全にランダムにリプレイメモリから情報を取り出すのではなく、最後にやった試合を必ず一度は読み込むような形の実装にした。

裏でこっそり実験していた Space Invaders や Kangaroo などのゲームは元のRainbowと遜色ないペース(あるいはもっと早く)でクリアしてしまった。AIガオガエンで試してもその強さは健在で、1ストック制の試合だと1日も経たずにLv1やLv2をクリアしてしまう。

これはLSTMレイヤー2枚の結果である。まずはLv1から。

途中でメモリ構造を変えたのでLossとQの値がおかしくなっているが、1200エピソード程度でクリアしたことがわかる。次にLv2のデータである。
Qがおかしくなっていたので最初からやりなおしたものだが、ほぼ同じような振舞いで1600エピソードでクリアしている。ガオガエンの挙動自体も興味深く、ロープスイングから頻繁にラリアットを決めたり速い段階で復帰らしいこともするようになっている。
LSTM2枚のモデルの途中で1枚にする実験などを挟んだが、この記事では2枚の結果だけをまとめて載せる。Lv3の結果は以下の図である。
上の図のLv2からの継続で、2500エピソードほどでクリアラインの0.5に到達している。目覚ましい成果である。このあとLv4に行くのだが、そこで次のような結果を出す。
Lv3での成果はどこへやら、勝率を大幅に落としてしまい、更にQも上がっていかない。これはどうしたことかと思い、一度Lv3終了時に戻ってそこからLv3を継続してみることにする。(ここで自滅が気になったので3ストック制に戻す。)
2700エピソード目あたりからが新しいデータになるが、結局Lv3に戻ってもスコアが伸びることはなく、むしろ下降していく傾向が見られた。

もしかするとLv3に上がってしばらくすると戦術の再調整を迫られることになり、必然的にスコアが下がるのかもしれない。だとすると最適なポリシーを再評価するまで淡々とトレーニングを続けないといけないのかもしれない。もう少し早く学習ができるネットワークで長期間回す必要があるのかもしれない。

次回は1枚レイヤーのRNNについて書く。

2021年9月16日木曜日

Lv4における2週間の停滞

何が成長を阻害している…?

もちろんLv3も順調ではなかったが、無事にLv3を乗り越えて帰ってきたLv4も順風満帆とはほど遠いものだった。Lv3を終えてからの二週間の修行の結果がこちらである。

(Reward: 報酬、 Episode Length: 各エピソードの長さ、 Q: 報酬予測値、 Loss: 予想と現実の差、 それぞれ20試合分くらいの移動平均)

何か変わった? むしろ悪くなってない…? 11000エピソードあたりから少し上昇した気はするけれど、最後下がってるし…。

また何週間かすれば上がってくるのかもしれないし、このまま落ちていくのかもしれない。

この間何もなかったわけではない。このエージェントのコードが公開された。整理するのは大変だったけれど、環境を綺麗にしておくと開発が楽になるので自分のためになる。

そして開発を楽にした結果、実際に開発を始めたのである。リカレント(再帰・回帰)レイヤーを含むエージェントである。これについての詳細は次項に持ち越すことにする。

2021年9月3日金曜日

Lv4 への寄り道と Lv3 への栄光の帰還、そしてまた Lv4へ


 Lv3マルスは倒れた。

前の記事でどうしてもLv3を倒せずに停滞した話をした。作戦会議の結果、Lv4に行ってみることにした。同時にこちらの論文のFigure 4でライフが複数あるタイプのAtariのゲームだと、ゲームオーバーでエピソード終了にするよりも、ライフが1つ失われた段階でエピソード終了にする方がスコアの伸びがよい、という結果が出されていたことを思い出したので、それをスマブラに適用してストックを1つにする変更もした。

その結果がこちらである。

Rewardは微妙に上がった。QはLv3のときのものを引き継いだのでLv4に合わせて下降した。後半も振動は見られるが顕著な上昇は見られない。これが約一週間のトレーニングの成果である。

1ストック制に移行してからゴールをどこに設定していいのかよくわからなかったのだが、3ストックのときに1.5だったので、単純に計算して0.5にしてみた。Lv4では0.0に触れることもかなわなかったわけだが、一週間Lv4で修行した結果、Lv3ではどうなるのか…。その結果が次のグラフである。

なんと、始めてから一日も経たずにゴールラインの0.5を越えてしまったのである。Qの調整が行われてLv3用の戦い方になるのに1500から2000エピソード程度かかった節はあるが、いともあっさりと設定したゴールラインを越えてしまった。

正直なところ、統計的なゆらぎを考えると3ストックで1.5のゴールの方が1ストックで0.5のゴールよりもシビアな気はするので、実際に強くなったから攻略したのか、単純に上振れが激しく起こったからなのかはわからない。しかし、0.5を複数回越えてそのあたりでしばらく滞在している様子を見るとまあ合格点にしてもいいんじゃないかという気はする。

というわけで晴れてLv4に進むことになった。ストック数は1を維持していきたいと思う。既にある程度データがあるので今後どう伸びるのかが楽しみである。

こうなってくるともうひたすら時間をかけてトレーニングさせるより他ない気がしてきた。

トレーニングの様子はずーっと配信しているので、進捗はYouTubeの配信でどうぞ。

https://www.youtube.com/channel/UCTR4c0xE-pIFgSoE6bFVPmw


2021年8月30日月曜日

深層強化学習AIガオガエン FAQ

Q: これは何?

A: 機械学習の一種である深層強化学習を用いて、スマブラ(ガオガエン)をプレイするコンピュータプログラムを作る実験です。

Q: 何でこんなことしてるの?

A: 趣味です。人智を越えたスマブラのスーパープレイ、見てみたくないですか…? 開発の経緯が見たければブログの過去の記事をここから辿って見てください。

Q: どうやって動いてるの?

A: Arduino をコントローラ代わりにしてスイッチにコマンドを入力し、出力はキャプチャーボードでパソコンに取り込みます。ゲームは無改造のSwitchの実機で実行されています。詳しい説明や写真などはセットアップの記事を参照してください。ダメージや撃墜の計算は取り込んだ画像を解析して行われています。

Q: どうしてガオガエン…?

A: 作成した人のメインだからです(このファイターのいい動きをよく知っている、というのが大きい)。あと、ガオガエンは強いです。

Q: どうしてマルス…?

A: 飛び道具がなく、単発攻撃が多い近距離ファイターから適当に選びました。

Q: どうしてエレクトロプランクトン(ステージ)…?

A: 一番シンプルで動きも少なかったので。グリーンバックみたいであまり見栄えはよくないかもしれません…。ピクトチャットも考えたけど背景が意外と動いたので却下しました。

Q: 右上のグラフの意味は?

A: Reward は直近20試合程度の報酬の平均値です。報酬は1ストックあたり2ポイントで、ダメージはその部分点がもらえます(100%で1程度)。どういう倒し方をしても最終的に1ストックで2ポイントになるように設定されています。Qは報酬の予測値みたいなものだと思っていただければいいかと思います。直近10000ステップ程度の平均を出しています。

Q: 最新鋭の強化学習アルゴリズム使ってんのに弱くない?

A: どんなアルゴリズムを使っても強化学習にはかなり多くのトレーニングデータが必要になります。実機でデータを出している以上、強くなるまでにはそれなりに時間がかかります。この世に生まれてからまだ1ヶ月くらい、と考えるとそれなりにがんばってる気がしませんかね…?あと、コードにバグが入ってないとも限りません。

Q: 自分もやってみたいんだけど、簡単にできる?

A: デジタル回路とプログラミングの経験が多少あればできると思います。プログラムのセットアップが少々ややこしいですが、ちゃんと数日かけてやることをやればできるはずです。実行に必要なコードと解説はこちらに置いておきました。README_ja.md が日本語での説明になっています。

Q: 本当に成長してるの? 弱くなってない…?

A: 実のところわかりません…。Rewardが上昇傾向にあれば成長していると言えますが、かなり振れ幅があるので、数日単位で見て確認するのがよさそうです。そのうち勝率の上昇の統計的優位性等も出せたらいいなとは思っています。

Q: 自滅しまくるのは何で?

A: 正直なところよくわかりません。ただ、最初よりはかなりましになっています。もしかしたら、この強化学習エージェントは一般化が苦手で、ありとあらゆる状況で自滅してみないとわからないのかもしれません。

Q: どうしてダメージの初期値が12%なの?

A: ダメージ認識を数字ではなく色を使って認識しているからです。0から12%までは色が白で変わらないので、最初から小さな変化を認識できる12%から始めています。

Q: CPUのマルスを倒せるようになったらどうするの?

A: 今のところは、他のCPUともやってみるとか、マルスも深層学習にして互いを相手に練習させるとかを考えています。いいアイディアがあれば Twitter の DM などで教えていただけると嬉しいです。

Q: 最新情報やまとめはどこで見たらいい?

A: 新しい情報は Twitter で発信しています。ここで答えられていない質問等にも答えます。こちらからどうぞ。

深層強化学習AIガオガエンはこういう感じで動いている!

 線がごちゃごちゃなのは許してくれ。


ちなみに配線図はこんな感じ。

以下、材料の詳細。
  • M1 Mac mini (2020) RAM 8GB, SSD 256GB (80,000円くらい)
    • メモリがギリギリなので余裕があれば16GBの方がいいかも。
    • たくさんのメモリとGPUを積んだLinuxが理想的とは思うけど、動作の保証はできない。
  • Elgato HD60 S+ (23,000円くらい)
    • +のないモデルはMacで読めないのでだめ。
    • UVCプロトコルを用いたモデルであればこれでなくても使用可能かも。
  • Nintendo Switch (33,000円くらい)
    • ドックが必要なのでLiteはだめ。有機ELモデルはわからない(多分OKとは思う)。
  • シリアルポートデバイス (1,500円くらい)
    • FTDIチップが乗ってれば他のでもいけるかもしれないけど、挙動が違うかも。
  • Arduino UNO R3 (3,000円くらい)
    • 互換機でもいけるかもしれないけれど挙動が違うかも。
その他インターフェイス系(モニタ、マウス、キーボード)などは多分何でもいいので適当なものを使ってください。ElgatoのOut端子から出てくる信号を表示するサブモニタがあると動作確認に便利。

2021年8月24日火曜日

Lv3マルスが倒せないよ

想像以上の強敵だった…。

Lv3のマルスは強敵であった。色々環境を整え、配信も可能にし、新しい計算機を用意して氷嚢の必要性をなくし、2週間ほど放置しても、クリアライン(報酬の移動平均 >= 1.5)を越えることはなかった…。

これがその戦いの歴史である。

1エピソードあたり2,3分かかるので6500エピソードとなるとざっと270時間程度か。空き時間もあったが、約二週間分のデータでこれである。4000エピソード目くらいまでは成長を感じていたが、その後無慈悲にも下降した。3500くらいまではLossとQが並んで増加していたが、4000あたりから乖離が見られるような気もする。これがまずかったんだろうか…?
ガオガエン自体は別段特に壊れた様子もなく、復帰も徐々にうまくなっているし、ロープスイングのラリアット(タイミングよくボタンを押さないといけないやつ)もだんだん出せるようになってきているので、成長自体はしているのかもしれない。しかしやはり自滅が治らないのである…。明らかに復帰できる状況で復帰しなかったり、余計な入力を入れて落ちていったりしてしまう。

今後どうやってマルスと付き合っていくか考えようと思い、生放送で意見を募ることにした。こちらの放送である。
内容をざっとまとめる。まず上記のような問題を説明し、こちらから色々案を出した。

  1. ネットワーク・アルゴリズムをいじる
  2. Lv3をとばしてLv4にしてみる
  3. ファイターを変えてみる(自分、あるいは相手)
  4. 何もしないでこのまま続ける
  5. 入力を変える(画面のサイズ、HD振動の情報、音声など)
  6. 報酬関数を変える(自滅にさらにペナルティなど)
いつも来ていただいている視聴者さん達からさらに、「生存点を与える」等のアイディアを頂き、まずは簡単にできそうな案2から始めてそれでも駄目なら案5、6(生存点も含む)へと進む提案をいただいたので、そうすることにした。

配信の後にAtariのゲームの場合だとゲームオーバーをエピソードの終わりにするのではなく、ライフを1つ失った時点で終わりにした方がエージェントの成長が早いといデータがあったことを思い出した。これをスマブラにあてはめると、3ストック制ではなく、1ストック制にした方が成長が早まるかもしれないと思いそれも同時にやることにした。

Lv3を倒せないまま飛び級をしたようなものだが、果たしてどうなることか…。
ガオガエンの今後はなるべくライブ配信していこうと思っているので、気になる方は気が向いたときに時々見に来ていただけるとありがたい(コメント欄でのご意見等も歓迎)。

チャンネルはこちら。

2021年8月11日水曜日

Mac を カフェイン漬けにしてフレーム落ちを防ぐ

人も計算機も怠ける。

Lv3マルスは手強く、学習も進展が見えづらい。そんな状況で兼ねてから懸念していた事に取り組んだ。取得しているビデオフレームが具体的にどうなっているかの検証である。

キャプチャーカードのフレームレートは基本的に60Hzなのだが、開発初期の検証によって、ビデオフレームが均一のタイミングで来ているわけではない事がわかっていた。具体的にはだいたい12msの整数倍の間隔で、最終的に60Hzになるようなタイミングで来ている。例としては (12, 12, 24, 12, 24, 12, 12, 24) といった間隔である。周期性もわかりづらく、12msが1回だけ挟まる回もあれば2回挟まる回もある。24msが連続で来ることは(たぶん)ない。20Hzでの動作を目的としているので、3フレームごとに画像を取得したいのだが、その間隔は48ms から 60 ms (実測した時もだいたいこの間隔になる。23msのやつが2回くるか1回来るかで変わってしまう)と、安定しないものになる

今まではあまり気にせずに1ステップごとにタイマーを設定して、「一周したあとで46ms経っていない場合は46msになるまで待つ」というアルゴリズムでやっていて、大体平均して20Hzのデータを作り出していた。しかし、この方法だと実際に何フレームスキップしたのかもよくわからないし、遅延でフレームドロップがあった際に認識することもできない。

もし全てのフレームが問題なく読めるのであれば、3フレーム取得して2フレーム分は捨てる、という選択もできるかもしれないが、今までの実装ではコントローラへの出力も同時に行うと60Hzで画面を読み込むことができない、という問題があった。

そこで、コントローラの方をコードを見てみると、コマンドを出力したあと、スイッチ側からの入力を確認するようにできている。これがだいたい一周期あたり16msで、ビデオ出力の60Hz (16.666...Hz)と微妙に異なる値になっていた。この周期に一致しないとコマンド出力が完了しないことになっていたのでビデオフレーム取得と同時にやると双方が干渉して60Hzの取得は不可能、という形になっていた。

少し検証してみた結果スイッチ側からの入力を無視してもコントローラ操作は可能らしく、フレームレートが十分に遅ければほぼコマンド入力を落とすことなく操作できることがわかった。(本来はスレッドを立ててやるべきなのかもしれないが…)これでスイッチ側からの入力を待つ時間を削除できるので、コマンド入力の時間が最大16msかかっていたものを1ms以下に抑えることができた。

コントローラ操作の時間を削減できたので、他の障害がなければビデオフレームをだいたい60Hzで入力できるようになった。他の障害がなければ、と書いた。障害になるものがいくつかあったのである。

まずは学習を行うスレッドである。CPUを100%近く使う計算を常時行っているので、これが稼動しているときは60Hzが厳しくなる時もある。これについては60Hzで取得するのを諦めて、タイミング測定とビデオフレーム取得を繰り返すことで解決した。具体的にはフレームを取得できた時点で前回取得時の時間と比べて、40ms以下だった場合はまだ3フレームスキップされていないと判断してもう一度取得し、そうでなければ受け入れる、というものである。そのときに時間を記録しておき、もし65ms経過していた場合はフレーム落ちの可能性があるとして報告するようにした。この処理をすることで、前よりも強く3フレームごとに取ることの保証が可能になり、問題がある際も認識できるようになった。

もう1つ問題になったのが、Macの謎の挙動である。スクリーンセイバーや、ディスプレイをオフにする設定に関係なく、1、2分ユーザからの入力がないと勝手にフレーム落ちを初めるのである(怠けモードと呼ぶことにする)。この現象があることは以前から気がついていたのだが、落としたフレームの数を数え始めたことによってより顕著に問題視されるようになった。怠けモードに入る前はフレーム落ちは0.1%以下程度(一試合3000ステップで最大2フレーム程度)なのに対し、怠けモードに入ると10%程度も落とすようになる(一試合100-500フレーム!)。これはまずいと思い対策を考えることにした。

まずはソフトウェアでの対処を考え、無理なようならUSBの疑似HIDを作って一定間隔で何か入力をしてもらうようにしようと思い、まずはソフトを探してみた。どうやら caffeinate というコマンドが元々 Mac に入っているらしく、これが一時的にスクリーンセイバー、ディスプレイの消灯、ディスクの回転停止などの電源関係の機能を抑制してくれるらしいことがわかった。

試した結果、caffeinate では怠けモードは解消されないことがわかった。他にも色々調べた結果、怠けモードは他の省エネ機能 (App Napやら何やら)とも関係ないこともわかった。次に試そうと思ったのがマウスやキーボード入力を勝手に定期的にしてくれるソフトで、 Caffeine がそれに該当するらしいことがわかった (少なくとも昔は、「本来存在しない F15 というキー」を押し続けるソフトだったらしい)。導入し、Karabiner Element のインスペクタで確認しても、F15なるキーの入力がなかったので、不安に思いながらもしばらく放置した結果、無事に怠けモードに入るのを回避できたのである!

これらの試行錯誤の結果、フレーム落ちは合計で0.1%以下にまで抑えることが可能になり、今までよりもずっと綺麗なデータを取得することが可能になった。データのクオリティは学習に直接影響を与えるので、これは大きな変化かもしれない。今まで配信ソフトが起動しているときどんだけフレーム落としてたんだ…? 検証の必要がある…。

色々直した結果、現在の学習状況はこんな感じである。

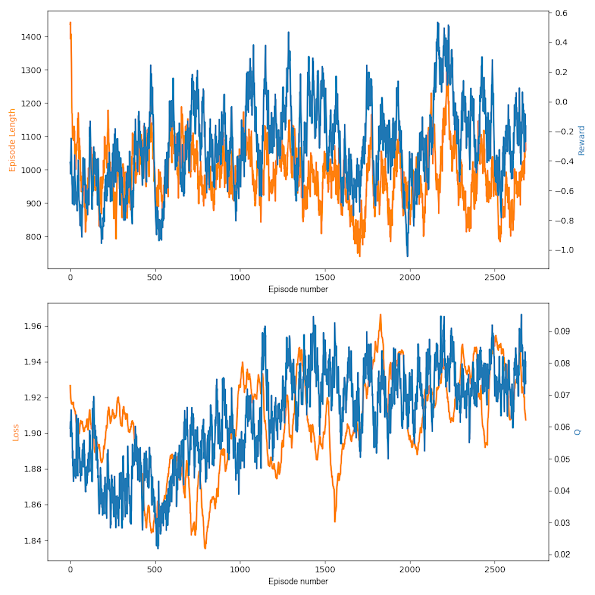
上のグラフが報酬(青、左Y軸)とロス(橙、右Y軸)で、下がQ値(青、左)と試合の長さ(橙、右Y軸)である。X軸は共通して試合数である。報酬もロスも一定のパターンが見えづらい変化をしているが、Q値はある時期(400試合目くらいか)から着実に伸びてきている。このパターンはLv2の時も見られたので、勝ちパターンだと思いたい。グラフを用意したのが途中からで、これはLv3の最初からではないのだが、ここまででもだいたいLv2のときの2倍くらいの時間がかかっている気がする。ちなみに本稿の修正を施したのはグラフの1000試合目くらいである。

これで直すべきところは直した。あとはAIガオガエンを信じて練習を続けてもらうだけだ。

2021年8月9日月曜日

冷凍庫の安堵の溜息

冷凍庫は安心したかもしれない。

Mac Miniを買ってしまった。ベースモデルで、M1, RAM:8GB, SSD:256GB という構成である。$699で、現状これより安いMacはない。現行のMacはどうせ全部M1だし、強化学習専用マシンにするつもりだったので、今のMacbook Airと同じベースモデルで十分だろうと思いこのモデルにした。オンラインのアップルストアで注文してから1時間半で届いたのには驚いた。将来もっとパワフルなMacが出る際にはこれを売ってアップグレードするかもしれない。

TimeMachineで今の環境を移したところ、ほぼ全てのソフトが作業することなくそのまま動いた。neovimがちょっとだだをこねたのと、USBシリアルポートデバイスのデバイス番号が変わったこと以外は何事もなく、強化学習環境の移行は2時間程度で終わった。

Mac Miniには排熱ファンがついている。MacBook Air の時はパフォーマンスの低下を抑えるために筐体を氷嚢の上に置いていたが(1日3回変える必要がある。アンパンマンのシステムに似ているかもしれない)、もうその必要はない。冷凍庫は毎日3つのなまぬるくなった氷嚢を再冷凍する必要がなくなったのだ。(なお、冷凍庫が冷却の再に排出する熱を溜息にたとえるのなら、溜息の回数は減ることになる。)

余も強化学習のために奪われていたパソコンを返してもらえて御満悦である。やはりパーソナルな計算機は手近なところに必要である…。

Lv2クリア!

 まっすぐな道ではなかった。

レベル1のマルスと比べて動きの種類は増えたものの、まだ何もしない時間も長くスマッシュに勝手に入ってくるため、最初のうちは難なく勝っているように見えた。目標とする報酬の移動平均を1.5に設定したが、開始間も無く1.46程度まであがり、そこからしばらく0.5付近をさまよってから1M(学習)ステップ後に到達した。かかった時間は1日半程度だったか。多少雑だがLoss, Q値, 報酬のグラフを下に掲載する。


いつでも上がれそうな雰囲気でもあったが、そうでなかったのは偶然なのだろうか。最初上がった報酬が下がったときはネットワークが壊れたのかとも思ったが、どうやらそうではなく単純にLv1とLv2の違いに合わせようとしただけなのかもしれない。Lossが増えていったのは多少不安だったが、Q値がほぼ線形に伸びていっていたのでこれはおそらく正しい変化をしているのだと信じて先に進んだ結果、無事到達することができた。

Lv3への到達がなんと配信中に起こったのでアーカイブを残すことができた。クリアするのは動画の最後の方である。

次はLv3…。ここからCPUも少し強くなってくる。

2021年8月5日木曜日

The cat is under training...

 AIガオガエンは成長を始めた。

前回投稿した時から小さな変更(学習率を小さくし、変化幅も狭めた)を加えたが、それ以外はそのままでしばらくトレーニングを続けている。どうやら学習は無事に行われているようだ。変更を加えてから半日程度でLv1のマルスと五分の勝負をするようになり、もう半日程度で7割程度勝つようになった。自滅の頻度も減った。

復帰はLv1マルス相手だと練習する回数が少ないためまだちゃんとできるわけではない。攻撃もスマッシュを溜めて相手が入ってくるのを見て殴るという、Lv1にしか効果がないような戦術をとっているが、これは想定内だ。Lv1を相手にしているのでそれに最適な行動をとるようになったのはむしろ喜ばしい。相手のレベルに応じて適応していく可能性を秘めている。

これがLv1マルスを倒すようになった時の記録である。


勝率が高すぎても低すぎても学習の効率が悪くなるだろうからマルスのレベルを上げることにした。前回の反省をふまえて今回は1つずつ上げていく。今はLv2のマルスと戦っている。Lv1とは違いジャンプ、ダッシュ、DA、掴み、ガードなどを使ってくる。(今思えばLv1はこれらのどれもしなかった…。)攻撃の頻度はまだ低いので似た戦術が通用しなくはないはずだ。

初期の勝率は五割弱。丁度よさそうである。これがまた上がってきて、報酬の移動平均が1.5程度になったら再度レベルを上げるつもりである。

2021年8月3日火曜日

変化する学習率と exploration-exploitation balance

昨日淡々と学習させると言ったが、あれは嘘だ。

結局翌日になっても何の成果も挙げられなかった素振りを見せるガオガエン。このあいだ学習率を下げたときにはすぐに勝率を上げていったのだが、今回はまた同様に停滞した後で学習率を下げても何もおこらなかった。まあ、色々変更があったし、前回よりも学習したステップの数が少なかったので、そのせいかもしれないが、よくなることを期待していたためにがっかりした。

結局試行回数を稼がないといけないのかもしれないが、ここでまた別のアイディアを着想してしまう。学習率が正しいのかよくわからないのであれば、時間変化させてしまえばいい。学習率を周期的に変動させる方法は実は一般的に使用されていて、成果も出しているのだが、失念していた。AtariのKangarooで試してみたところ、学習が劇的に早まったので、とりいれてみることにした。値は広くとって基本の値の10倍から1/10まで、周期はとりあえず5万ステップにしてログスペースでcosで周期振動させてみる。長く停滞する期間があるようならこの方法は有効なはずだ。

というのも強化学習には長く exploration-exploitation balance (探索と収束のバランス)の難しさというものがある。探索をしすぎると解答に収束できないし、収束を早くしすぎると最適解に辿りつけなくなる可能性がある。そのバランスをとるにはいい妥協点を見つけないといけないのだが、これが難しいのである。

周期的に変化する学習率は高いときは探索を促進し、低いときは収束を促進する。うまくやればいいとこどりになりうる。失敗する可能性があるとすれば、低いときに収束した点から遠ざかってしまうことが考えられるが、これが起こっている場合は報酬やQ値に反映されるだろうから、少なくとも観測は可能と考える。

さて、明日からは淡々と学習させる日々が続くはずだ。