2021年11月13日土曜日

順調に育つエージェントができた

とりえあずのお祝いを。

前回の記事の終わりで、さもパフォーマンスが落ちる原因がわかったかのような口を聞いたが、仮説検証のために色々と実装をしたものの結局のところパフォーマンスが落ちる原因はわからなかった。しかもコードの重要な部分にバグがあるのも見つかり、しっちゃかめっちゃかになった。バグの修正後に比較的安全なパラメータ調整をして臨んだところ安定して成長するようになったのである。今回の記事はそのあたり(10月上旬あたりから約1ヶ月程度)のまとめになる。長くなることを最初にお伝えしておく。

過学習と正則化

前回の最後に立てた仮説は「過学習によってそれまでと少しでも違う動きをする相手に対応できなくなっている」というものであった。過学習とはデータの中の一般化できない部分にまで適応してしまう現象のことである。深層学習では過学習をどのようにして避けるかが一つの大きなテーマにもなっており、様々な手法が開発されている。データの数が少なければ少ないほど過学習のリスクも高まる。こちらの記事に詳しく解説されている。

深層強化学習の場合はデータを常に作り続けるために他の深層学習の分野と比較して過学習に対する対応が薄い。このプロジェクトで使っているRainbowというモデルでも明示的に過学習を防ぐ方法は取られていない。Rainbowの論文ではAtariのゲームのシミュレータを用いているので、データ取得と学習のステップをどの程度の比にするかを選べるようになっている。ここでデータ取得の頻度を比較的大きくしておけば過学習を防ぐことができる仕組みになっている。

AIガオガエンの場合は実機を用いるためデータ取得の頻度が実時間で決めらている。一方学習は別スレッドで動いているためステップ数はCPUに可能な最大値となっている。LSTM2枚程度のモデルではだいたいRainbow論文と同程度、つまり4ステップごとに1回程度のペースで学習をする。一回の学習で32ステップを読み込むため、実時間に対して8倍程度の速度で学習をすることになる。これもRainbow論文と同程度である。

これだけ聞くと過学習の心配はなさそうに感じるがもちろん環境が違うためちゃんと成長するために必要なデータの分量も変わってくる。LSTM1枚のモデルが2枚のものより早くパフォーマンスが落ちるのを観測したとき、過学習の可能性を疑ったのである。

過学習が起こったらどうすればいいのか。先述の記事にもあるように、「正則化」を行うのが順当な手法である。このプロジェクトでは最適化の手法であるAdamにWeight Decayを加えたAdamWというものを使った。

もうお分かりかと思うが、これで問題は解決しなかった。詳細は割愛するが、Weight Decayを導入してもパフォーマンスの低下は防げず、逆にWeight Decayを弱めたところから成長を始めるエージェントなどもいて、かえって邪魔になっている印象であった。

色

次に試されたのが色が見えるエージェントである。Rainbow論文にならってAIガオガエンは白黒の映像を与えられていたが、ステージが緑色、ガオガエンが赤、マルスが青で、それぞれのカラーチャンネルにうまく対応していたため色が見えるエージェントは物の識別が用意になるのではないか、という仮説があったからである。色を導入するとデータ量が増えるため、今までよりも少ない数のリプレイメモリしか保存できなくなるのがトレードオフである。

これも試されたものの、白黒のエージェントに勝ることはなく、短期間で実験を終えることになった。

ハイパーパラメータチューニング

試せる案が減ってきたので、ノイズを増やす、マルチステップの数を変える、などの妙な変更を始めた。ここで試したかったことは、「パフォーマンスの低下は過学習の結果ではなく、ガオガエンが成長する上で必要なステップで、それを越えた先に成長がある」という仮説の検証であった。このエージェントでは成長速度を上げるため、裏でやっていたAtariのパラメータを一部ひっぱってきてやっていた。つまり、バッチサイズを大きく(32→128)し、学習率を上げる(1e-5→1e-4)という方法だったのだが、どういうきまぐれからかLSTMレイヤーの数は3枚にしてみた。

蓋を開けてみると、このエージェントの成長はとても遅かった。バッチサイズを大きくし、ネットワークを重くした結果、データ取得に対する学習ステップが100ステップに1,2回程度まで下がってしまい、結果Lossの現象は今までのLSTMモデルより随分ゆっくりになった。次のグラフはLSTM1枚のモデルと今回のモデルの比較である。両方Lv3スタートである。


Lossが2.0程度に戻ってくるまでに先のモデルは500エピソード程度だったが、今回のモデルは3000エピソード近くかかっている。そしてこのエージェントはその後もゆっくりと成長を続け、Lv3をクリアする直前まで来た。ここまでにおよそ5日程度かかっている。

ここで一度クラッシュしたのと、メモリ構造を書き換えるために止めたため、クリア前ではあるがLv4に移行することにした。以下がLv4の経過である。
しばらく走らせたものの、クリア目標である70%に到達するのは遠いように見えたので、クリア条件を60%に改めてクリアしたことにした。次がLv5の経過である。

ここに来て減速を始めたのである。結局駄目だったかと落胆したものである。パフォーマンスが下がるにつれてガードが増え、クラッシュするまで守るようになったのが印象的であった。パフォーマンスが落ちつつも試合時間が長くなっているあたりにその様子が間接的に伺える。

未来予測型

その次に試されたのが未来予測型のネットワークである。情報を処理するLSTMの前に未来を予測する部分を並列で作り現在の情報と予測された未来の情報の両方を使って最適な行動を選べる(はずの)エージェントである。次の図の左側の水色の線の部分が未来予測の部分である。

着想はSSBMの深層強化学習を行ったFiroiu氏のこの論文からである。AIガオガエンの約300msの入力遅延を未来予測でごまかせないかという話である。

結果から言うと、未来予測型がしっかり完成する前に、回帰ネットワークまわりのバグが見つかったので保留になった。なのでこの部分は未完成である(一応完成はしているが未検証、といったところか)。

回帰ネットワークのバグ

問題は「トレーニングの最中に同じネットワークを2回使ってしまっていた」というものであった。回帰ネットワークでなければ何度使おうが同じ入力には同じ結果を返すので問題ないのだが、回帰ネットワークは内部状態を持つため2回使うと違う結果が出るし、その次のステップ移行にも影響してくる。トレーニングにおいても同じネットワークは一度しか使ってはいけないのだ(内部状態を元に戻すという処理も可)。今回は2回使わなければいけない場面でネットワークを2つ用意するという対応をとった。

このバグに間してはバッチサイズを大きくすることによってもある程度対策が可能なため、バッチサイズの大きくした時にパフォーマンスが低下しにくくなる1つの理由となり得た。

GRU vs LSTM

回帰ネットワークのバグを修正するついでに計算を軽くしたい欲求も出てきた。もし今まで成長していなかったのが回帰ネットワークのバグのせいならばLSTM1枚でもちゃんと成長する可能性がまだ残っている。

それと同時に、今までのLSTMの知見が眉唾ものになったために、少し他の事を試すいい機会になった。GRUというLSTMと同等の性能でパラメータが少なく計算と学習が少し早い回帰層があり、これとLSTMのどちらを使うか迷った結果今まではLSTMを使っていたのだが、ろえを機会にGRUを試してみることにした。以下がGRUでLv3から学習を始めたときの結果である。

最初大きなバッチサイズ(4096だったか)で始めて、2200epあたりで成長の遅さにしびれを切らしてバッチサイズを小さく(128)した。そこからしばらく走らせたものの、パフォーマンスの低下が見られたので仕方なく打ち切った。LSTM3枚のモデルがうまくいっていたため、このままここで時間を使うのは勿体ないかと思い、これも一旦保留にしてLSTM3枚のモデルに戻ることにした。

最後の変更:バッチサイズをランダムに

結局まともに動いているならいいかということでLSTM3枚でLv5で調子がよかったあたりから再開した。次のグラフの14000epあたりから修正されたLSTM(バッチサイズ大)が始まる。
バッチサイズの変更の伴って報酬は急上昇し(QもLossも)あっさりとLv5をクリアした。Lv6も同様でさほど苦労せずに攻略した。Lossはバッチサイズを大きくして以来増え続けている。
Lv7の途中で少し成長に鈍化が見られた。
上昇を続けていたLossもここで現象に転じ、過学習の様相を見せ始めた。ここで、新たな正則化の手法を導入した。バッチサイズを固定された数からランダムに変更したのである。

学習に用いるデータは1試合ずつ取り出して使われるのだが、バッチサイズを固定しておくと、同じ試合を取り出した時に切り分け方がいつも同じになる。これをランダムにすることで、同じ試合でも別の切り方になり、ネットワークにとって少しずつ違うデータに見えて、正則化が働くのではないかという算段である。

そのランダム化を3700epあたりで導入した結果、以下の図のようにパフォーマンスがまた回復してLv7をクリアすることができた。最後急激に報酬が落ちたが、あまり気にしないことにした。その後もこのエージェントは順調に成長し、ついに当初の目標であるLv8のCPUマルスを攻略した。

これで少なくとも安定して成長するエージェントができたことになり、いよいよAI同士によるセルフプレイの準備を始められる段階に入った。

確認事項1: クイックモードをやめたらどうなるのか

今までのトレーニングの大部分はデータが速くとれるクイックモードでやっていたが、通常モードと比べると入力遅延がやや大きい、フレームスキップがより頻繁に起こる、FPSが微妙に違うなどの問題があって通常モードに戻したときにどうなるかという検証が行われていなかった。人間は通常の時間でプレイしているため、通常モードで動かせないのは致命的になる。セルフプレイを本格的に始める前に通常モードに移行できるかを確かめることにした。

クイックモードでLv8マルス攻略まで鍛えたガオガエンを通常モードで戦わせた結果がこちらである。

ご覧の通り、最初こそ少しパフォーマンスを落とすものの、比較的簡単に順応することがわかる。

確認事項2: 終点から戦場にするとどうなるか

もう1つ確認しておきたかったのが台の有無にどう対応していくかである。スマブラは縦にも横にもキャラが動くゲームで、ステージ上の浮遊する台の存在によって戦術の幅が大きく広がる。もし実戦を意識するのなら、台有りでの戦いは避けられない。セルフプレイを始めるにあたって、台なしの環境で育ててしまった場合、台ありにシフトしたかったら両方のエージェントを同時に鍛えなおす必要がある。ゲーム内CPUが使えるうちに台の有無に適応できるかの確認をしておきたい。

次の図は、Lv8CPUマルスを終点で倒したガオガエンが戦場(両方エレクトロプランクトンではあるが…)を使った時の結果である。

クイックから実時間に変更した時と比べて最初のパフォーマンスの落ち込みは大きかった。ほぼ全然勝てない状態に戻ったものの、そこそこの時間で勝率を5割程度まで戻すことができた。

この挑戦中にセルフプレイ用の機材が届いたので、このエージェントを叩き台としてセルフプレイを開始することにした。

続きは次の記事で…。


2021年9月23日木曜日

回帰型ネットワーク(LSTM1枚からまた2枚へ。あれ?)


 2枚のとは違うのか?

大した違いはないんじゃないだろうか。結局のところ回帰レイヤーは自分の出力が自分に返ってくるのでNユニットの2枚のLSTMでできることは2Nユニットの1枚のLSTMでだいたい可能である。(返ってくるまでに1ステップの時間がかかるので全く同じというわけではないが。)

同じユニット数だともちろん2枚の方が色々なキャパシティが上がるとは思うが、同時に回帰レイヤーのトレーニングは時間ステップを遡りながら行うので重くなりがちである。実際に1枚のものと2枚のものではだいたい3割程度、1ステップの学習速度に違いが出る。

一方シンプルな系(Atariのゲーム)で学習成果を試したところ、1枚のものも2枚のものもだいたい同じステップ数だと同程度のパフォーマンスになる。だとすると1ステップあたりの学習が早い1枚のものの方が有利だということだ。もちろん複雑な系の場合はどうなるか不明である。

最初2枚のものから始めたのは、PyTorchのデフォルトの値が2枚だったからで、特に深い理由はなかった。その後、OpenAIのDota2のAIがLSTM1枚で行われていることなどを知って、1枚の方がよいのではないかと思うようになった。

で、1枚のものと2枚のもの、試したところ実際どちらがよかったのかという話だが、残念ながら結論が出なかった。次の2枚の図を見ていただきたい。


上が1枚のもので、下が2枚のものである。枚数以外はほぼ同じ条件である。2枚のものはゴールラインの0.5を越えたので止めたが、1枚のものは越えなかった。Rewardだけ見ると勿論2枚の方が成績がよいのだが、このあたりの数値はノイズが大きくもある。Lossの値を見ると確かに1枚のものの方が早く収束しているし、値も低く保たれている。Qの最終値も大きいし、何なら先に0に到達したのは1枚のものの方だ。どちらが先に0.5に到達したかというのは、偶然性の寄与するところが大きいように思われる。

問題はこの後だった。2枚にしようかな、と思ってその先に進んだ結果、途中で成長が止まってしまったのだ。次の図はLv2をクリアした2枚のモデルでLv3に進んだ結果である。

まだ順調に進んでいる。Qの値がふらついているのも相手の変化に合わせて再調整したためと読みとれる。そして、Lv4である。
突然勝率を下げ始めたのである。行動にもおかしな様子が顕著に現れていた。自滅の数が極端に多くなったのである。Qも下がりっぱなしで元に戻る気配もない。このあと2枚のモデルでLv3の最後から始めたり、3ストックにしたりLv2まで戻したり、1枚のモデルでやったり学習率を上げたりしたが、結局どのモデルもある段階まで学習すると、そこからパフォーマンスを下げて戻らなくなることのが観測された。回帰ネットワークを導入する前は確かそのようなことはなかったと思うのだが、これはいったいどういうことなのだろうか…。
次の記事では、なぜそうなったかの仮説と、解決策についての議論をする。


2021年9月20日月曜日

回帰型(再帰型)ネットワーク(LSTM2枚)

 強い。

時系列予測などによく用いられる回帰型ネットワークを実装した。英語では Recurrent Neural Network (RNN) と呼ばれ、再帰型ネットワークとも訳される。出力を次のステップの自分の入力に入れることでループを形成し、原理的には無限ステップ離れた過去の情報にもアクセス可能になる。詳しい説明はこちらの記事などを参考にされたい。(英語が読める場合はこっちのブログ記事の方がいいかも。) 今回の実装ではLSTM(Long-Short Term Memory; 長-短期記憶)という型のRNNを用いる。

時系列を認識するタイプのネットワークなので、時間の流れを適切な順序で入れてやる必要がある。今までの学習方法ではランダムな時間を取り出してきてトレーニングしていたので、変更する必要があった。新しい方法では1試合のデータを丸ごと取り出してきて、それを1から試合終了まで順番に入れることになった。バッチサイズは今まで通り32でも大丈夫なようだった。これに伴ってメモリ構造を一から書き直す必要があり、更に Prioritized Memory が(実装が面倒だという理由で)失われた。一応こちらの論文を参考にして、完全にランダムにリプレイメモリから情報を取り出すのではなく、最後にやった試合を必ず一度は読み込むような形の実装にした。

裏でこっそり実験していた Space Invaders や Kangaroo などのゲームは元のRainbowと遜色ないペース(あるいはもっと早く)でクリアしてしまった。AIガオガエンで試してもその強さは健在で、1ストック制の試合だと1日も経たずにLv1やLv2をクリアしてしまう。

これはLSTMレイヤー2枚の結果である。まずはLv1から。

途中でメモリ構造を変えたのでLossとQの値がおかしくなっているが、1200エピソード程度でクリアしたことがわかる。次にLv2のデータである。
Qがおかしくなっていたので最初からやりなおしたものだが、ほぼ同じような振舞いで1600エピソードでクリアしている。ガオガエンの挙動自体も興味深く、ロープスイングから頻繁にラリアットを決めたり速い段階で復帰らしいこともするようになっている。
LSTM2枚のモデルの途中で1枚にする実験などを挟んだが、この記事では2枚の結果だけをまとめて載せる。Lv3の結果は以下の図である。
上の図のLv2からの継続で、2500エピソードほどでクリアラインの0.5に到達している。目覚ましい成果である。このあとLv4に行くのだが、そこで次のような結果を出す。
Lv3での成果はどこへやら、勝率を大幅に落としてしまい、更にQも上がっていかない。これはどうしたことかと思い、一度Lv3終了時に戻ってそこからLv3を継続してみることにする。(ここで自滅が気になったので3ストック制に戻す。)
2700エピソード目あたりからが新しいデータになるが、結局Lv3に戻ってもスコアが伸びることはなく、むしろ下降していく傾向が見られた。

もしかするとLv3に上がってしばらくすると戦術の再調整を迫られることになり、必然的にスコアが下がるのかもしれない。だとすると最適なポリシーを再評価するまで淡々とトレーニングを続けないといけないのかもしれない。もう少し早く学習ができるネットワークで長期間回す必要があるのかもしれない。

次回は1枚レイヤーのRNNについて書く。

2021年9月16日木曜日

Lv4における2週間の停滞

何が成長を阻害している…?

もちろんLv3も順調ではなかったが、無事にLv3を乗り越えて帰ってきたLv4も順風満帆とはほど遠いものだった。Lv3を終えてからの二週間の修行の結果がこちらである。

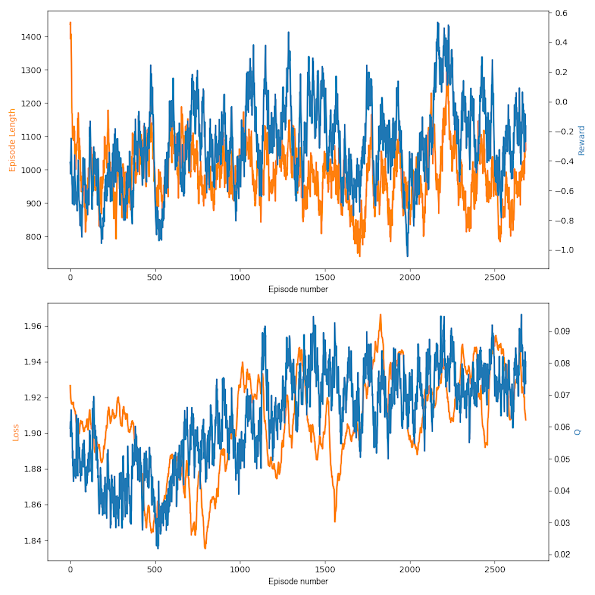
(Reward: 報酬、 Episode Length: 各エピソードの長さ、 Q: 報酬予測値、 Loss: 予想と現実の差、 それぞれ20試合分くらいの移動平均)

何か変わった? むしろ悪くなってない…? 11000エピソードあたりから少し上昇した気はするけれど、最後下がってるし…。

また何週間かすれば上がってくるのかもしれないし、このまま落ちていくのかもしれない。

この間何もなかったわけではない。このエージェントのコードが公開された。整理するのは大変だったけれど、環境を綺麗にしておくと開発が楽になるので自分のためになる。

そして開発を楽にした結果、実際に開発を始めたのである。リカレント(再帰・回帰)レイヤーを含むエージェントである。これについての詳細は次項に持ち越すことにする。

2021年9月3日金曜日

Lv4 への寄り道と Lv3 への栄光の帰還、そしてまた Lv4へ


 Lv3マルスは倒れた。

前の記事でどうしてもLv3を倒せずに停滞した話をした。作戦会議の結果、Lv4に行ってみることにした。同時にこちらの論文のFigure 4でライフが複数あるタイプのAtariのゲームだと、ゲームオーバーでエピソード終了にするよりも、ライフが1つ失われた段階でエピソード終了にする方がスコアの伸びがよい、という結果が出されていたことを思い出したので、それをスマブラに適用してストックを1つにする変更もした。

その結果がこちらである。

Rewardは微妙に上がった。QはLv3のときのものを引き継いだのでLv4に合わせて下降した。後半も振動は見られるが顕著な上昇は見られない。これが約一週間のトレーニングの成果である。

1ストック制に移行してからゴールをどこに設定していいのかよくわからなかったのだが、3ストックのときに1.5だったので、単純に計算して0.5にしてみた。Lv4では0.0に触れることもかなわなかったわけだが、一週間Lv4で修行した結果、Lv3ではどうなるのか…。その結果が次のグラフである。

なんと、始めてから一日も経たずにゴールラインの0.5を越えてしまったのである。Qの調整が行われてLv3用の戦い方になるのに1500から2000エピソード程度かかった節はあるが、いともあっさりと設定したゴールラインを越えてしまった。

正直なところ、統計的なゆらぎを考えると3ストックで1.5のゴールの方が1ストックで0.5のゴールよりもシビアな気はするので、実際に強くなったから攻略したのか、単純に上振れが激しく起こったからなのかはわからない。しかし、0.5を複数回越えてそのあたりでしばらく滞在している様子を見るとまあ合格点にしてもいいんじゃないかという気はする。

というわけで晴れてLv4に進むことになった。ストック数は1を維持していきたいと思う。既にある程度データがあるので今後どう伸びるのかが楽しみである。

こうなってくるともうひたすら時間をかけてトレーニングさせるより他ない気がしてきた。

トレーニングの様子はずーっと配信しているので、進捗はYouTubeの配信でどうぞ。

https://www.youtube.com/channel/UCTR4c0xE-pIFgSoE6bFVPmw


2021年8月30日月曜日

深層強化学習AIガオガエン FAQ

Q: これは何?

A: 機械学習の一種である深層強化学習を用いて、スマブラ(ガオガエン)をプレイするコンピュータプログラムを作る実験です。

Q: 何でこんなことしてるの?

A: 趣味です。人智を越えたスマブラのスーパープレイ、見てみたくないですか…? 開発の経緯が見たければブログの過去の記事をここから辿って見てください。

Q: どうやって動いてるの?

A: Arduino をコントローラ代わりにしてスイッチにコマンドを入力し、出力はキャプチャーボードでパソコンに取り込みます。ゲームは無改造のSwitchの実機で実行されています。詳しい説明や写真などはセットアップの記事を参照してください。ダメージや撃墜の計算は取り込んだ画像を解析して行われています。

Q: どうしてガオガエン…?

A: 作成した人のメインだからです(このファイターのいい動きをよく知っている、というのが大きい)。あと、ガオガエンは強いです。

Q: どうしてマルス…?

A: 飛び道具がなく、単発攻撃が多い近距離ファイターから適当に選びました。

Q: どうしてエレクトロプランクトン(ステージ)…?

A: 一番シンプルで動きも少なかったので。グリーンバックみたいであまり見栄えはよくないかもしれません…。ピクトチャットも考えたけど背景が意外と動いたので却下しました。

Q: 右上のグラフの意味は?

A: Reward は直近20試合程度の報酬の平均値です。報酬は1ストックあたり2ポイントで、ダメージはその部分点がもらえます(100%で1程度)。どういう倒し方をしても最終的に1ストックで2ポイントになるように設定されています。Qは報酬の予測値みたいなものだと思っていただければいいかと思います。直近10000ステップ程度の平均を出しています。

Q: 最新鋭の強化学習アルゴリズム使ってんのに弱くない?

A: どんなアルゴリズムを使っても強化学習にはかなり多くのトレーニングデータが必要になります。実機でデータを出している以上、強くなるまでにはそれなりに時間がかかります。この世に生まれてからまだ1ヶ月くらい、と考えるとそれなりにがんばってる気がしませんかね…?あと、コードにバグが入ってないとも限りません。

Q: 自分もやってみたいんだけど、簡単にできる?

A: デジタル回路とプログラミングの経験が多少あればできると思います。プログラムのセットアップが少々ややこしいですが、ちゃんと数日かけてやることをやればできるはずです。実行に必要なコードと解説はこちらに置いておきました。README_ja.md が日本語での説明になっています。

Q: 本当に成長してるの? 弱くなってない…?

A: 実のところわかりません…。Rewardが上昇傾向にあれば成長していると言えますが、かなり振れ幅があるので、数日単位で見て確認するのがよさそうです。そのうち勝率の上昇の統計的優位性等も出せたらいいなとは思っています。

Q: 自滅しまくるのは何で?

A: 正直なところよくわかりません。ただ、最初よりはかなりましになっています。もしかしたら、この強化学習エージェントは一般化が苦手で、ありとあらゆる状況で自滅してみないとわからないのかもしれません。

Q: どうしてダメージの初期値が12%なの?

A: ダメージ認識を数字ではなく色を使って認識しているからです。0から12%までは色が白で変わらないので、最初から小さな変化を認識できる12%から始めています。

Q: CPUのマルスを倒せるようになったらどうするの?

A: 今のところは、他のCPUともやってみるとか、マルスも深層学習にして互いを相手に練習させるとかを考えています。いいアイディアがあれば Twitter の DM などで教えていただけると嬉しいです。

Q: 最新情報やまとめはどこで見たらいい?

A: 新しい情報は Twitter で発信しています。ここで答えられていない質問等にも答えます。こちらからどうぞ。

深層強化学習AIガオガエンはこういう感じで動いている!

 線がごちゃごちゃなのは許してくれ。


ちなみに配線図はこんな感じ。

以下、材料の詳細。
  • M1 Mac mini (2020) RAM 8GB, SSD 256GB (80,000円くらい)
    • メモリがギリギリなので余裕があれば16GBの方がいいかも。
    • たくさんのメモリとGPUを積んだLinuxが理想的とは思うけど、動作の保証はできない。
  • Elgato HD60 S+ (23,000円くらい)
    • +のないモデルはMacで読めないのでだめ。
    • UVCプロトコルを用いたモデルであればこれでなくても使用可能かも。
  • Nintendo Switch (33,000円くらい)
    • ドックが必要なのでLiteはだめ。有機ELモデルはわからない(多分OKとは思う)。
  • シリアルポートデバイス (1,500円くらい)
    • FTDIチップが乗ってれば他のでもいけるかもしれないけど、挙動が違うかも。
  • Arduino UNO R3 (3,000円くらい)
    • 互換機でもいけるかもしれないけれど挙動が違うかも。
その他インターフェイス系(モニタ、マウス、キーボード)などは多分何でもいいので適当なものを使ってください。ElgatoのOut端子から出てくる信号を表示するサブモニタがあると動作確認に便利。